Ob es um KI-Chatbots oder erschreckend echte Videos und Bilder geht, die künstlich erstellt wurden: KI dominiert die aktuellen Themen von heute. Und wie es aussieht, wird das auch die nächsten Jahre noch so bleiben.
Aber wenn wir über KI reden, müssen wir auch über GPUs reden. Genauer gesagt, über GPU-Server. Sie sind das Rückgrat der KI-Welle, die die Welt überflutet. Sie stemmen so ziemlich die gesamte Rechenlast.
Aber nicht nur das: Für die ursprünglich gedachten grafikintensiven Arbeiten werden Grafikkarten natürlich auch noch verwendet – das heißt, zum Beispiel für komplexe 3D-Simulationen oder riesige Videorenderings.
In diesem Artikel klären wir, was ein GPU-Server überhaupt ist, wo seine Stärken liegen und für welche Aufgaben er sich wirklich lohnt.
Was ist ein GPU-Server?
Ein klassischer Server und dessen CPU erledigen viele Aufgaben: Datenbanken, Webserver, Webhosting oder Cloud-Dienste. Die Vorteile liegen dort, wo Prozesse schnell, flexibel und mit möglichst geringer Latenz ablaufen müssen. Die meisten Serverdienste kommen dabei ganz ohne GPU aus. GPU-Server sind also für speziellere Anforderungen gedacht.
Der große Vorteil der GPU ist die massive Parallelverarbeitung von Daten. Eine CPU arbeitet mit wenigen, dafür sehr leistungsfähigen Kernen. Eine GPU hingegen besitzt enorm viele Recheneinheiten, die noch mehr Operationen gleichzeitig ausführen können.
Stell dir den Prozessor als Sportwagen vor. Er ist klein, wendig und kann jede Kurve mit hoher Geschwindigkeit nehmen. Dafür passen nur zwei Personen (Daten) rein. Die GPU gleicht eher einem Linienbus. Er fährt einfachere Strecken ohne starke Kurven in einer moderaten Geschwindigkeit – aber dafür nimmt er 50 Personen gleichzeitig mit.
Trotzdem ersetzt die GPU den Prozessor nicht. Beide übernehmen unterschiedliche Aufgaben. Die CPU steuert Prozesse, bereitet Daten auf und koordiniert die Abläufe im System. Die GPU übernimmt dann die große Rechenlast. Erst im Zusammenspiel entsteht ein Server, der den speziellen Anforderungen von GPU-Aufgaben gewachsen ist.

Wofür du einen GPU-Server brauchst
Künstliche Intelligenz: der wichtigste Treiber
GPUs kommen vor allem im KI-Bereich zum Einsatz. Large Language Models (LLMs), KI-Bilderkennung oder andere anspruchsvolle KI-Modelle müssen große Datenmengen und viele Rechenoperationen parallel verarbeiten – perfekt für die Grafikkarte. Dabei gibt es drei Hauptphasen beim Bau eines KI-Modells. In jeder Phase muss der GPU-Server eine andere Last bewältigen:
Training: Im Pretraining wird ein Modell von Grund auf neu trainiert. Das bedeutet, es wird mit großen Datenmengen gefüttert, bis es ein allgemeines Verständnis entwickelt. Das ist extrem rechenintensiv, teuer und dauert Wochen bis Monate – typisch für Forschung, Big-Tech-Unternehmen oder Regierungen. Das Posttraining verbessert „Reasoning“-Fähigkeiten und entwickelt das typische Chatverhalten, das du von bekannten LLMs kennst. Das Ergebnis heißt Base-Modell.
Fine-Tuning: Das baut auf dem ersten großen Training auf. Unternehmen passen zum Beispiel ein bestehendes Base-Modell mit ihren eigenen, proprietären Daten an und machen es so zum Experten für ein bestimmtes Fachgebiet. Das Modell antwortet dann präziser und konsistenter. Ein kleineres, fein abgestimmtes Modell löst manche Aufgaben sogar besser als ein großes ohne Anpassung – und spart dabei Kosten.
Fine-Tuning ist mittelmäßig speicher- und rechenintensiv und lohnt sich für Firmen jeder Größe.
Inferenz: Diese Phase beschreibt die Anwendung des Modells. Es wird also nicht mehr angelernt. Ein Chatbot, der auf einer Webseite Supportfragen beantwortet, ist ein klassisches Beispiel.
Rendering, CAD und Visualisierung
Ursprünglich war die GPU ja in der Grafikwelt zuhause. Bewegtbilder lassen sich in sehr kleine Teilberechnungen aufteilen, die die Grafikkarte dann abarbeitet. Eine starke GPU verkürzt die Rechenzeit dabei enorm. Große Videorenderings und detailreiche 3D-Szenen profitieren am meisten. Aber auch CAD-Programme für technische Zeichnungen und Konstruktionen sowie anspruchsvolle Bild- und Videobearbeitung laufen damit spürbar flüssiger.
Wissenschaftliche Simulationen
Wettermodelle, Molekülsimulationen oder thermodynamische Berechnungen: Wie bei KI fallen auch hier gewaltige Datenmengen an, die parallel berechnet werden müssen – nur steht diesmal die Mathematik im Vordergrund. Eine leistungsstarke GPU beschleunigt solche Rechnungen deutlich.
Worauf es bei der Hardware ankommt
VRAM als entscheidende Kenngröße
GPU ist nicht gleich GPU. Generation und Modell verraten bereits, für welche Aufgaben sich ein Server eignet – ob KI, Rendering oder Visualisierungen.
Eine der wichtigsten Kennzahlen ist der VRAM, also der Grafikspeicher. Er entscheidet darüber, wie viele Daten die GPU direkt verarbeiten kann. Das betrifft sowohl KI-Modelle als auch komplexe 3D-Szenen. Denn alles, was die GPU gleichzeitig bearbeiten soll, muss in ihren Grafikspeicher passen. Ist er zu klein, bringt auch die schnellste GPU nichts.
Grob als Orientierung:
- Bis rund 40 GB VRAM: gut für kleinere bis mittlere Modelle, Inferenz sowie viele GPU-beschleunigte Aufgaben wie Bild- oder Videoverarbeitung und CAD.
- Rund 40 bis 100 GB VRAM: besser für größere Modelle und viele Fine-Tuning-Szenarien. Hier sind auch höhere Batch-Größen und längere Kontexte möglich. Das heißt: Du kannst mehr Daten gleichzeitig verarbeiten und das Modell kann größere Eingaben gleichzeitig bearbeiten.
- Über 100 GB VRAM: sinnvoll für sehr große Modelle, Multi-GPU-Setups und Spezialfälle.

CPU, RAM und Storage als Unterstützer
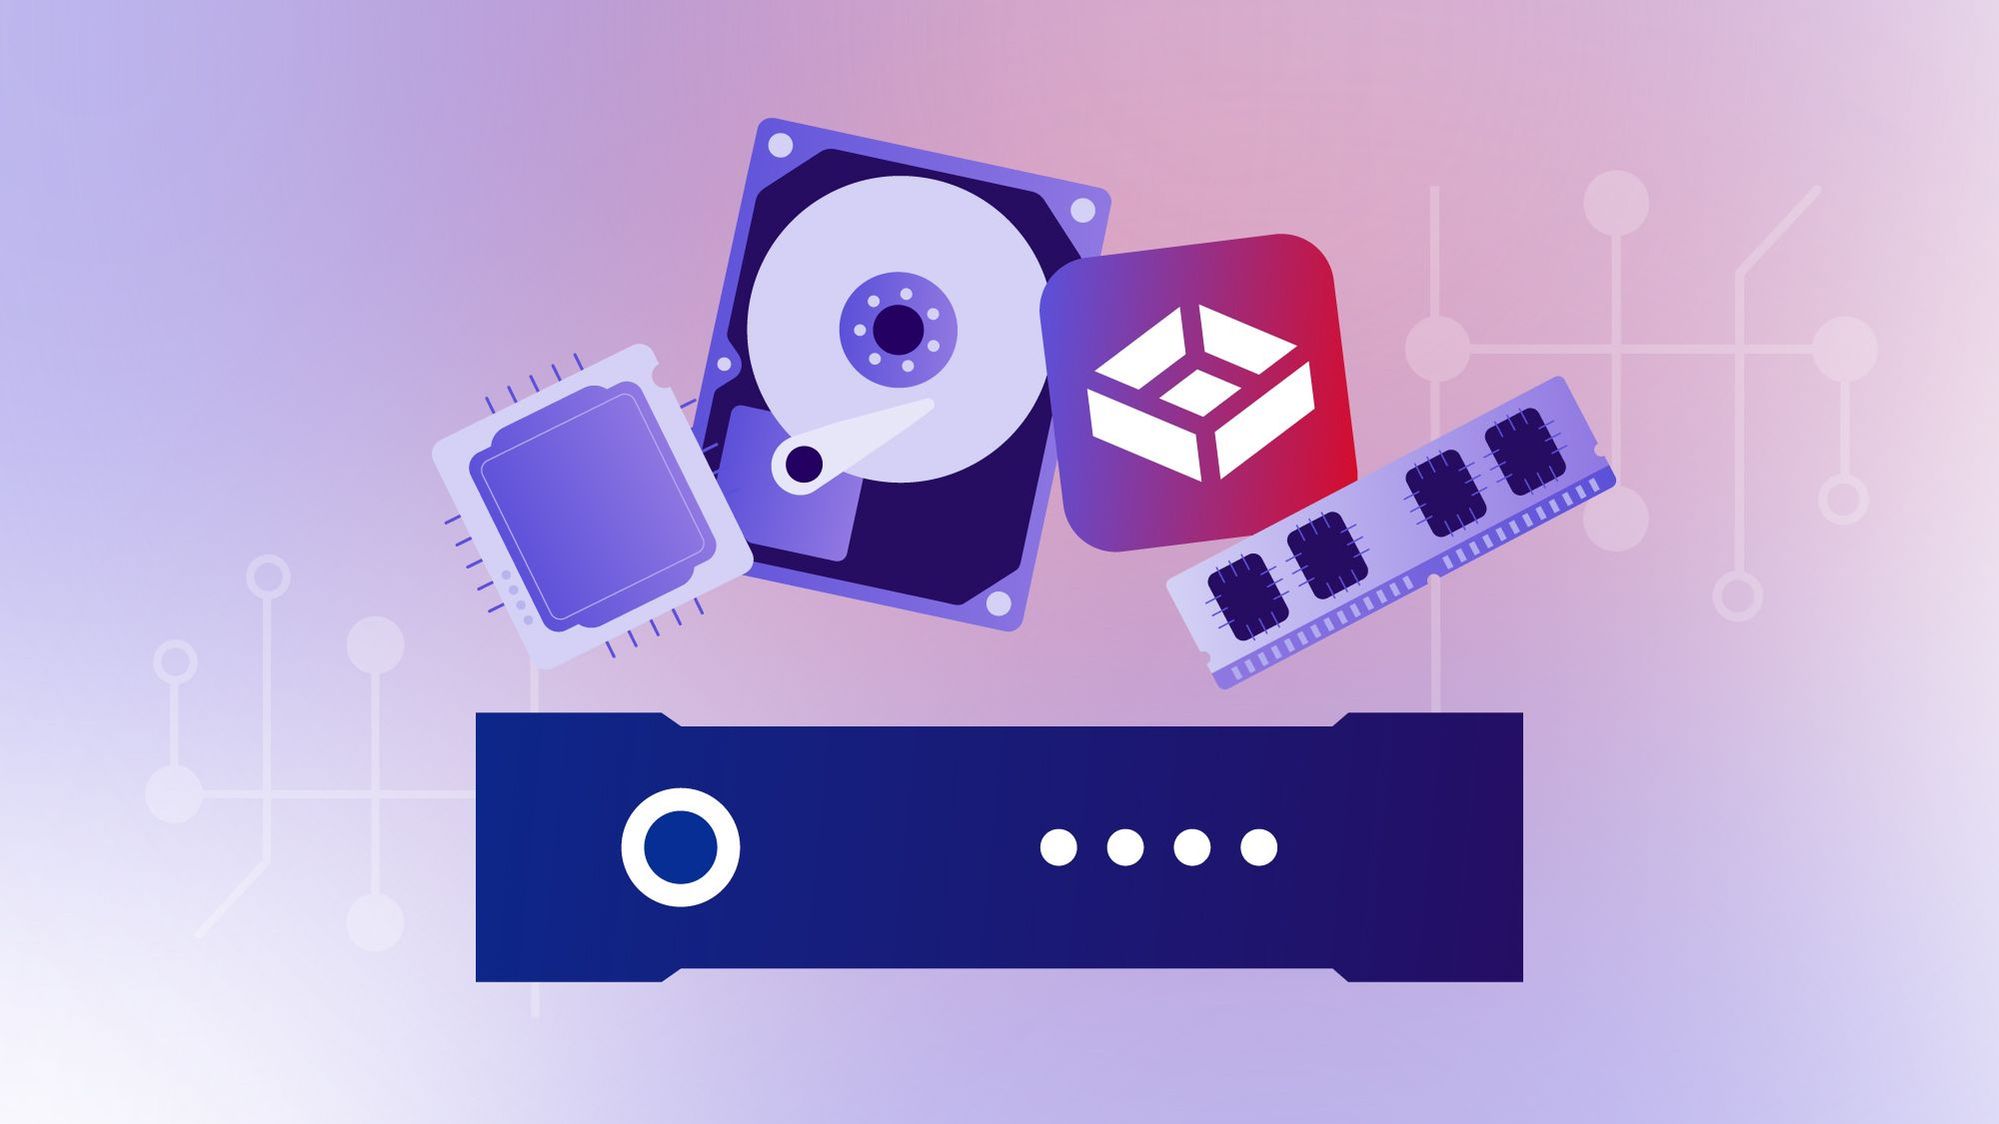
Entscheidend ist aber nicht nur die GPU allein. Auch CPU, Arbeitsspeicher und Storage müssen zur Rechenlast passen. Die CPU steuert Abläufe, bereitet Daten auf und versorgt die GPU mit neuen Aufgaben.
Arbeitsspeicher und schnelle SSDs sorgen dafür, dass Daten rechtzeitig bereitstehen und der Workflow nicht stockt. Dabei zählt nicht nur, wie viel Speicher vorhanden ist, sondern auch, wie schnell die GPU darauf zugreift. Deshalb sind NVMe-SSDs die richtige Wahl. ECC-RAM erkennt und korrigiert zusätzlich Speicherfehler. Das ist vor allem im wissenschaftlichen und professionellen Umfeld relevant.
CUDA, Tensor Cores und RT Cores
Unsere GPU-Server verwenden Grafikkarten von NVIDIA. Und wer NVIDIA sagt, muss auch CUDA sagen. Aber Achtung, Verwechslungsgefahr: CUDA Cores sind Recheneinheiten der GPU, während mit CUDA die Software- und Entwicklungsplattform von NVIDIA gemeint ist.
Diese Plattform ist im Bereich GPU-Computing besonders weit verbreitet. Viele KI-Frameworks wie PyTorch oder TensorFlow, aber auch Rendering-Software, setzen darauf.
Tensor Cores beschleunigen Matrixberechnungen, die die Grundlage moderner KI-Modelle bilden. RT Cores dagegen sind auf Raytracing spezialisiert: ein Verfahren, das realistisches Lichtverhalten simuliert. Dadurch beschleunigen sie vor allem Rendering-Aufgaben und andere grafisch anspruchsvolle Darstellungen.
Finde den passenden GPU-Server
Ob Single- oder Multi-GPU: Du hast die Wahl. Finde den Server, der zu deinem KI-Workload passt.
Welcher GPU-Server passt zu dir?
KI und somit auch GPUs entwickeln sich mit rasanter Geschwindigkeit. Sie übernehmen die unterschiedlichsten Aufgaben und sind in vielen Arbeitsprozessen von Firmen verankert. Damit wird der passende GPU-Server für immer mehr Unternehmen zur entscheidenden Frage.
Doch mehr Leistung bedeutet nicht automatisch bessere Ergebnisse. Wer einen GPU-Server einsetzen möchte, sollte seine Anforderungen genau kennen. Wie groß sind die Datenmengen? Wie viel VRAM wird benötigt? Und welche Aufgaben soll die GPU übernehmen? Wer diese Fragen beantworten kann, hat bereits eine gute Grundlage für die Wahl der passenden Hardware.